목차
로컬 AI를 구축할 때 가장 먼저 고민하는 부분은 어떤 언어 모델을 사용할 것인가이다.
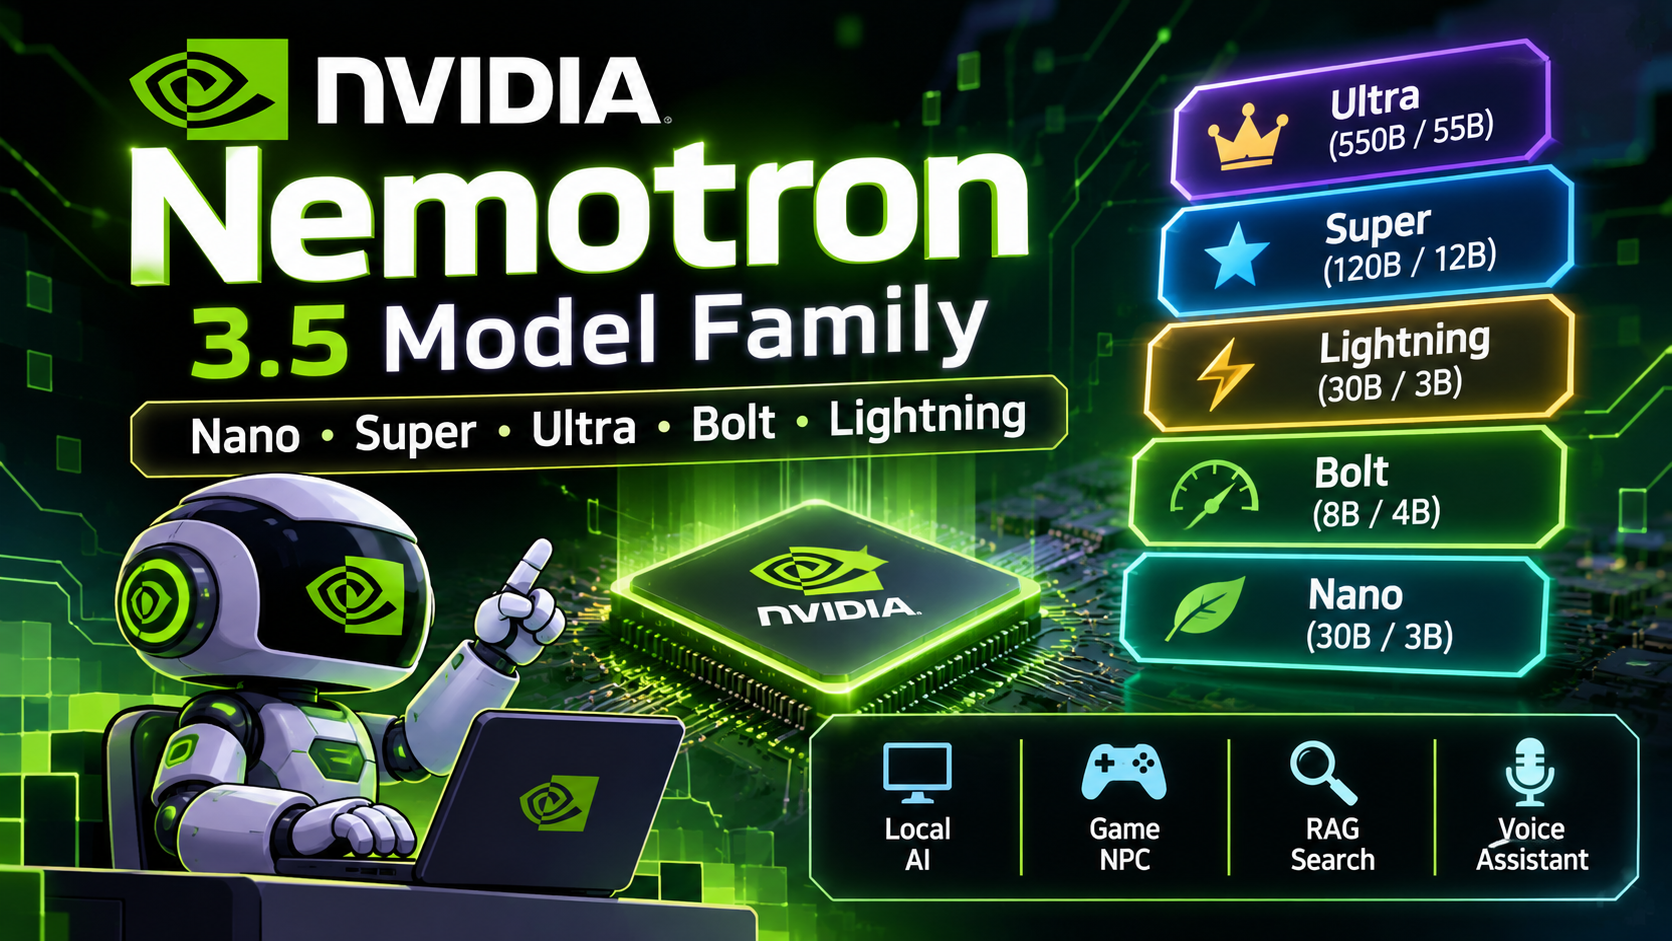
NVIDIA는 GPU와 AI 가속 기술뿐 아니라 자체 AI 모델 제품군인 Nemotron도 개발하고 있다. Nemotron은 단일 언어 모델이 아니라 일반 대화와 추론, 로컬 AI 에이전트, 멀티모달 처리, 음성 인식, 문서 검색 등 다양한 작업에 맞춰 구성된 모델 제품군이다.
특히 Nemotron 3와 Nemotron 3.5 계열에는 4GB급 로컬 모델부터 수백억 개 이상의 파라미터를 사용하는 대규모 모델까지 포함되어 있다.
이번 글에서는 NVIDIA Nemotron의 주요 버전과 특징을 살펴보고, 각 모델의 차이, 용도별 선택 방법, Windows에서 직접 실행하는 방법까지 정리한다.
1. NVIDIA Nemotron이란?
Nemotron은 NVIDIA가 개발한 개방형 AI 모델 제품군이다.
모델 가중치뿐 아니라 학습 데이터와 학습 레시피, 기술 보고서 등을 공개해 개발자가 모델을 평가하고 자신에게 맞는 AI 시스템을 구축할 수 있도록 지원한다.
일반적인 챗봇뿐 아니라 다음과 같은 용도로 활용할 수 있다.
- AI 에이전트와 자동화 시스템
- 코드 생성 및 소프트웨어 개발
- 문서 요약과 데이터 분석
- 이미지 및 영상 이해
- 음성 인식과 음성 기반 인터페이스
- 의미 기반 문서 검색(RAG)
- 콘텐츠 안전성 검사
Nemotron의 중요한 특징은 모델을 크기와 목적에 따라 나누어 제공한다는 점이다.
모든 작업에 가장 큰 모델을 사용할 필요 없이, 빠른 응답이 필요한 작업에는 작은 모델을 사용하고 복잡한 추론에는 큰 모델을 사용하는 식으로 구성할 수 있다.
2. Nemotron 3 주요 모델
Nemotron 3는 Nano, Super, Ultra 세 가지 주요 모델을 중심으로 구성된다.
Nemotron 3 Nano
30B 전체 파라미터 / 3B 활성 파라미터
Nano는 Nemotron 3 제품군에서 효율적인 추론과 전문 에이전트 작업을 담당하는 모델이다.
Mixture of Experts(MoE) 구조를 사용해 전체 300억 개 파라미터 중 토큰을 처리할 때 약 30억 개의 파라미터를 활성화한다.
주요 활용 분야:
- 문서 요약
- 코드 분석과 디버깅
- 정보 검색
- AI 비서
- 전문 업무용 하위 에이전트
별도로 Nemotron 3 Nano 4B Dense 모델도 공개되어 있다. 이 모델은 MoE 방식의 30B 모델과 다른 소형 모델이므로 혼동하지 않는 것이 좋다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3-Nano-30B-A3B-BF16
2-2. Nemotron 3 Super
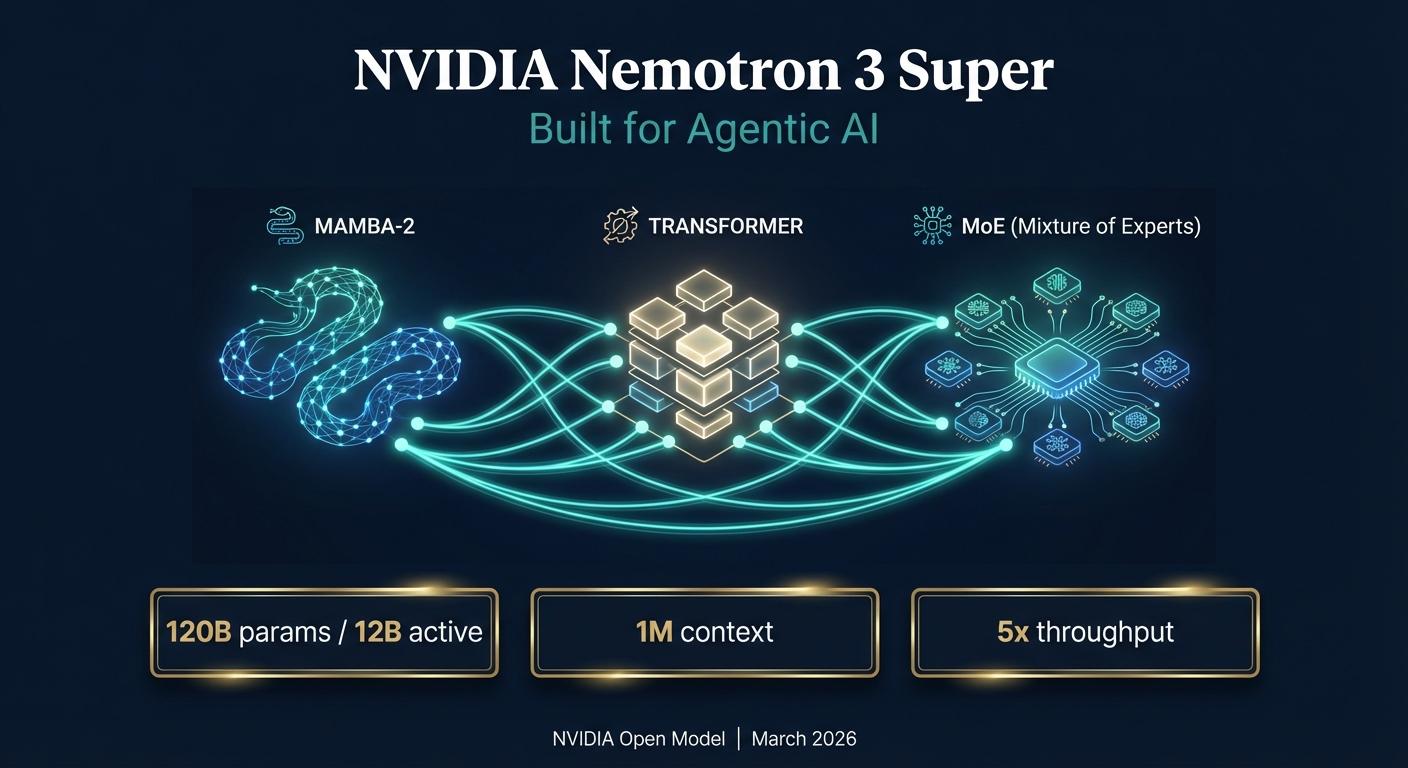
120B 전체 파라미터 / 12B 활성 파라미터
Super는 복잡한 추론과 여러 에이전트가 협업하는 작업을 위한 모델이다.
Nano보다 큰 모델 용량을 바탕으로 복잡한 지시 수행, 계획 수립, 여러 단계의 문제 해결에 초점을 맞춘다.
주요 활용 분야:
- 복잡한 데이터 분석
- 여러 AI 에이전트의 작업 조율
- IT 업무 자동화
- 코드 생성 및 검토
- 다단계 추론
120B 전체 모델이므로 일반적인 6GB 또는 8GB 그래픽카드에서 실행하기에는 적합하지 않다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-BF16
2-3. Nemotron 3 Ultra
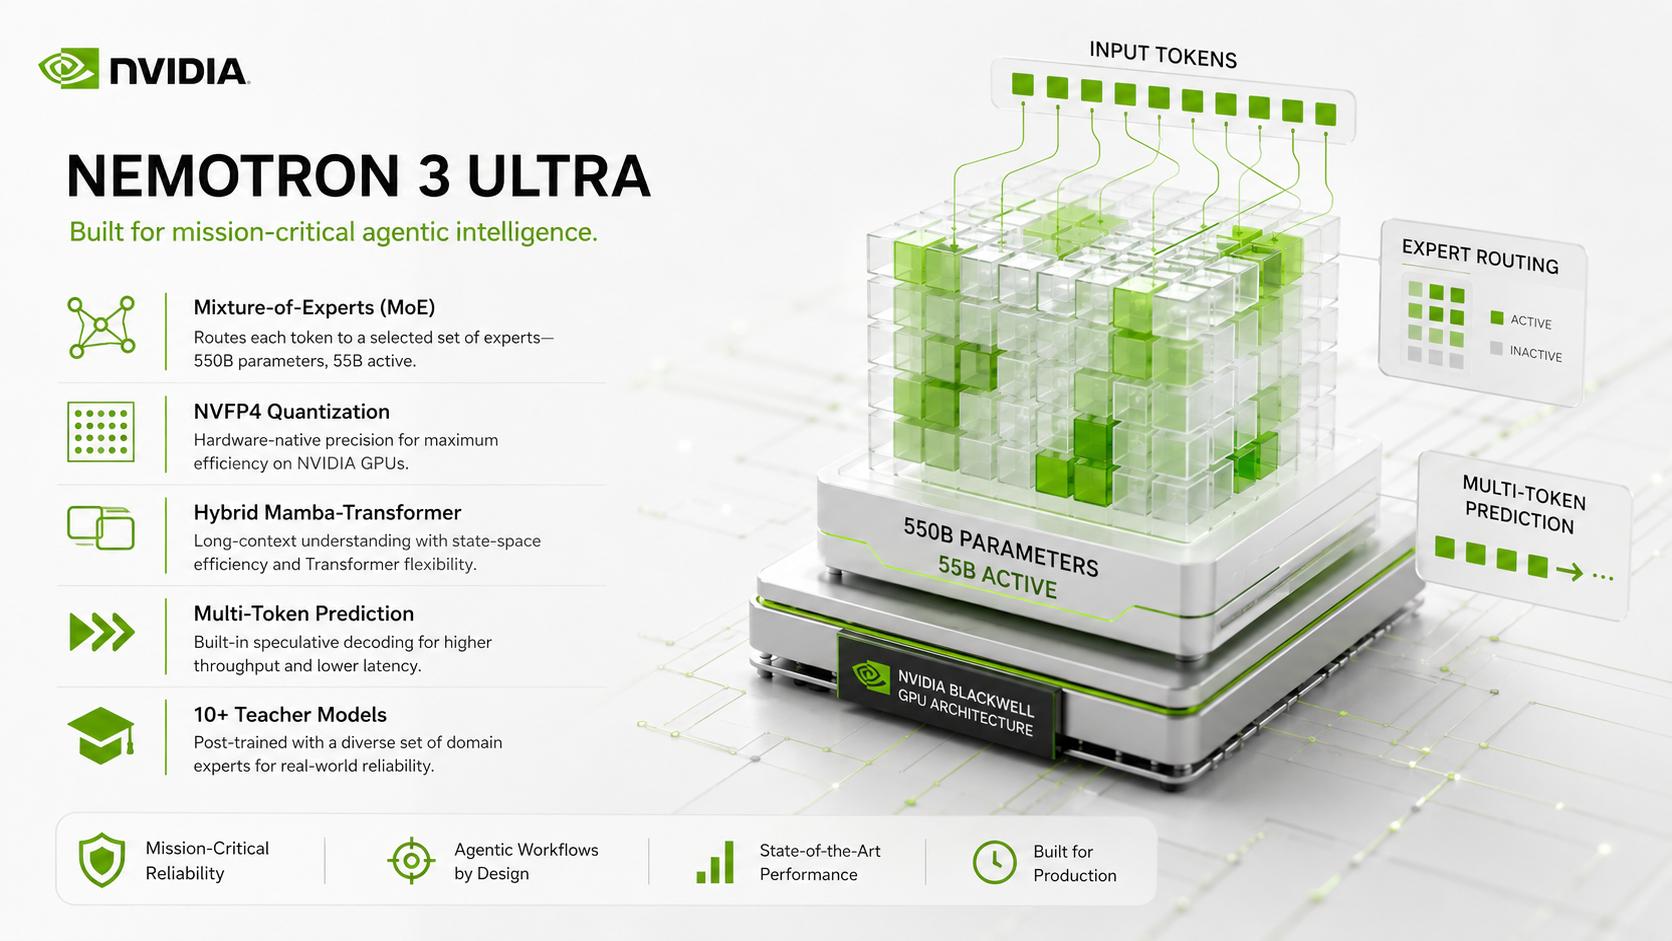
550B 전체 파라미터 / 55B 활성 파라미터
Ultra는 Nemotron 3 제품군에서 가장 큰 규모의 모델이다.
복잡한 문제를 해결하기 위한 추론 능력과 장시간 이어지는 에이전트 작업에 초점을 맞춘다.
주요 활용 분야:
- 복잡한 소프트웨어 개발
- 심층적인 연구 및 분석
- 장기적인 작업 계획
- 대규모 에이전트 시스템
- 기업용 AI 자동화
최대 100만 토큰의 문맥 처리를 지원하며, 일반적인 개인용 PC보다는 대규모 GPU 서버 환경에 적합하다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-BF16
3. Nemotron 3.5 주요 모델
Nemotron 3.5는 기존 Nemotron 3 제품군을 확장한 모델과 전문 기능을 포함한다.
특히 로컬 환경에서 사용할 수 있는 Bolt 계열이 추가되면서 개인용 PC에서도 접근할 수 있는 모델 선택지가 넓어졌다.
3-1. Nemotron 3.5 Bolt E4B 4GB
8B 전체 파라미터 / 4B 활성 파라미터
이번 제품군에서 개인 사용자가 관심을 가질 만한 모델이다.
Gemma 4 E4B Instruct를 기반으로 NVIDIA가 후속 학습을 진행했다.
주요 특징:
- 약 4GB급 메모리 사용을 목표로 설계
- 빠른 대화 응답
- 여러 차례 이어지는 대화
- 도구 호출과 지시 수행
- 로컬 음성 비서와 대화형 캐릭터
게임 NPC, 소형 로컬 AI 비서, 임베디드 장치와 연결하는 AI 에이전트에 적합하다.
다만 4GB는 모든 실행 환경에서 필요한 VRAM이 정확히 4GB라는 의미는 아니다. 실제 메모리 사용량은 컨텍스트 길이와 실행 프로그램에 따라 달라진다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
3-2. Nemotron 3.5 Bolt 74B-A9B 24GB
74B 전체 파라미터 / 9B 활성 파라미터
Bolt E4B보다 훨씬 큰 모델로, 약 24GB 메모리 환경에서 로컬 AI 에이전트를 실행하는 것을 목표로 한다.
대형 모델의 추론 능력을 유지하면서도 로컬 환경에서 실행할 수 있도록 Super VL 모델을 압축하고 양자화한 것이 특징이다.
주요 활용 분야:
- 로컬 AI 에이전트
- 복잡한 대화형 작업
- 여러 단계의 도구 사용
- 고성능 개인용 AI 시스템
RTX 3090 24GB나 RTX 4090 24GB 같은 환경을 고려할 수 있지만, 실제 실행 가능 여부는 양자화 파일과 컨텍스트 설정에 따라 달라진다.
공식 모델:
https://huggingface.co/nvidia/Nemotron-3.5-Bolt-74B-A9B-24GB
3-3. Nemotron 3.5 Lightning 30B-A3B
30B 전체 파라미터 / 3B 활성 파라미터
Lightning은 빠른 응답과 높은 처리 효율을 목표로 하는 텍스트 모델이다.
상시 실행되는 AI 에이전트나 반복적인 전문 작업에 적합하다.
주요 활용 분야:
- 빠른 텍스트 처리
- 반복적인 업무 자동화
- 전문 업무용 하위 에이전트
- 대규모 AI 시스템의 실행 단계
최대 100만 토큰 문맥을 지원하며, BF16과 NVFP4 등 여러 체크포인트가 제공된다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16
3-4. Nemotron 3.5 Super VL 120B-A12B
120B 전체 파라미터 / 12B 활성 파라미터
Super VL은 텍스트뿐 아니라 이미지와 영상까지 이해할 수 있는 멀티모달 모델이다.
일반적인 언어 모델이 텍스트 중심으로 작동한다면 Super VL은 시각 정보를 함께 분석할 수 있다는 차이가 있다.
주요 활용 분야:
- 이미지 분석
- 영상 내용 이해
- 화면을 인식하는 AI 에이전트
- 소프트웨어 화면 조작
- 시각 자료 기반 추론
문서나 이미지, 영상 정보를 분석하고 이를 바탕으로 도구를 사용하는 AI 시스템을 구축할 때 활용할 수 있다.
공식 모델:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16
4. Nemotron 전문 모델
Nemotron은 일반적인 대화형 모델 외에도 특정 작업을 수행하는 전문 모델을 제공한다.
이 모델들은 하나의 AI 시스템 안에서 서로 연결해 사용할 수 있다.
| 모델 | 주요 기능 | 활용 사례 |
| Nemotron 3.5 Transcribe 30B-A4B | 음성 인식 및 지능형 전사 | 회의록, 음성 번역, 화자별 기록 |
| Nemotron 3.5 ASR Streaming 0.6B | 실시간 음성 인식 | 실시간 자막, 음성 명령 |
| Nemotron 3.5 Content Safety 4B | 콘텐츠 안전성 검사 | 유해 콘텐츠 필터링 |
| Nemotron 3.5 Embed 1B | 문서 및 텍스트 임베딩 | 의미 기반 검색 |
| Nemotron 3.5 Embed 8B | 고성능 임베딩 | 대규모 문서 검색 |
| Nemotron 3.5 Rerank 8B | 검색 결과 재평가 | 검색 결과의 관련성 정렬 |
| Nemotron 3.5 Parse | 문서 구조 분석 | PDF, 이미지, 표 추출 |
Embed와 Rerank의 차이
문서 검색 시스템을 구축할 때 자주 등장하는 용어다.
Embed는 문장이나 문서를 숫자 벡터로 변환한다. 이를 이용하면 단어가 정확하게 일치하지 않아도 의미가 비슷한 문서를 찾을 수 있다.
Rerank는 검색된 문서 후보를 질문과 비교해 관련성이 높은 순서로 다시 정렬한다.
예를 들어 NAS에 저장된 수백 개의 문서에서 특정 문제의 해결 방법을 찾는다고 가정하자.
- Embed가 문서를 검색 가능한 형태로 변환한다.
- 검색 시스템이 질문과 유사한 문서를 찾는다.
- Rerank가 검색 결과의 관련성을 다시 평가한다.
- 언어 모델이 최종 답변을 작성한다.
이러한 구조를 RAG(Retrieval-Augmented Generation)라고 한다.
5. Nemotron 모델 비교표
전체 모델을 한눈에 비교하면 다음과 같다.
모델전체 파라미터활성 파라미터주요 용도
| Nemotron 3 Nano | 30B | 3B | 효율적인 에이전트 |
| Nemotron 3 Nano 4B | 4B | 4B | 소형 텍스트 처리 |
| Nemotron 3 Super | 120B | 12B | 복잡한 추론 |
| Nemotron 3 Ultra | 550B | 55B | 대규모 추론 |
| Nemotron 3.5 Bolt E4B | 8B | 4B | 4GB급 로컬 AI |
| Nemotron 3.5 Bolt 74B | 74B | 9B | 24GB급 로컬 AI |
| Nemotron 3.5 Lightning | 30B | 3B | 빠른 에이전트 |
| Nemotron 3.5 Super VL | 120B | 12B | 멀티모달 추론 |
파라미터 수는 모델의 크기를 이해하기 위한 기준이다. 실제 실행 속도나 성능은 양자화 방식, GPU, 메모리 대역폭, 실행 프레임워크, 컨텍스트 길이에 따라 달라진다.
6. Windows에서 Nemotron 3.5 Bolt E4B 설치하기
개인용 PC에서 직접 실행해 보려면 Bolt E4B 4GB 모델부터 시작하는 것이 좋다.
여기서는 Windows와 llama.cpp를 이용해 설치한다.
준비물
- Windows 10 또는 11 64비트
- NVIDIA GPU 또는 CPU 실행 환경
- llama.cpp
- Hugging Face 모델 파일
① llama.cpp 설치
PowerShell을 실행하고 다음 명령을 입력한다.
winget install llama.cppGPU 가속을 사용하려면 CUDA가 포함된 빌드가 필요하다. 공식 GitHub Releases에서 자신의 GPU와 CUDA 환경에 맞는 Windows 빌드를 선택할 수 있다.
공식 주소:
https://github.com/ggml-org/llama.cpp/releases
설치 후 버전을 확인한다.
llama --version② 모델 실행
Nemotron 공식 모델 카드에서 제공하는 명령을 사용하면 모델을 자동으로 내려받아 실행할 수 있다.
llama serve -hf nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB:Q4_K_M첫 실행에서는 모델 다운로드가 진행된다.
실행 후 로컬 웹 인터페이스와 API 서버를 이용할 수 있다.
http://127.0.0.1:8000이 방식은 모델 파일을 별도로 지정하지 않아도 되어 처음 설치하는 사람에게 편리하다.
③ 컨텍스트 설정
처음 실행할 때는 컨텍스트 길이를 무리하게 높이지 않는 것이 좋다.
- 처음 테스트: 4K~8K
- 메모리 여유 확인 후: 16K 이상
- 최대 문맥: 모델 카드 기준 64K
컨텍스트 길이가 커지면 추가 메모리가 필요하므로 GPU 메모리 사용량을 확인하면서 조절한다.
④ API 호출 테스트
서버가 실행 중인 상태에서 PowerShell을 하나 더 열고 다음 명령을 실행한다.
$body = @{
  model = "nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB"
  messages = @(
    @{
      role = "user"
      content = "Nemotron의 주요 특징을 설명해 줘."
    }
  )
  max_tokens = 512
} | ConvertTo-Json -Depth 10

Invoke-RestMethod `
  -Uri "http://127.0.0.1:8000/v1/chat/completions" `
  -Method Post `
  -ContentType "application/json" `
  -Body $body
정상적으로 응답이 반환되면 로컬 AI 서버가 작동하는 것이다.
7. 실제 활용 예시
게임 NPC에 적용하기
Nemotron Bolt E4B는 게임 속 NPC의 대화 엔진으로 활용할 수 있다.
예를 들어 다음과 같은 정보를 모델에 전달한다.
너는 판타지 RPG 세계의 무기 상인이다.

이름: 그레고리
성격: 신중하고 돈을 중요하게 생각한다.
말투: 중세 판타지 세계관에 어울리는 말투

현재 플레이어 정보:
레벨: 12
보유 골드: 350
현재 지역: 북부 마을

플레이어의 질문에 NPC의 입장에서 답변하라.
게임에 존재하지 않는 아이템이나 퀘스트를 임의로 만들지 마라.
플레이어가 "철검을 얼마에 팔지?"라고 물으면 NPC의 성격과 현재 상황을 반영해 대화를 생성하는 방식이다.
실제 게임에서는 아이템 가격, 인벤토리, 퀘스트 상태 등은 게임 서버가 관리해야 한다. AI는 대화 생성과 자연어 이해를 담당하도록 분리하는 것이 안전하다.
NAS 관리 도우미
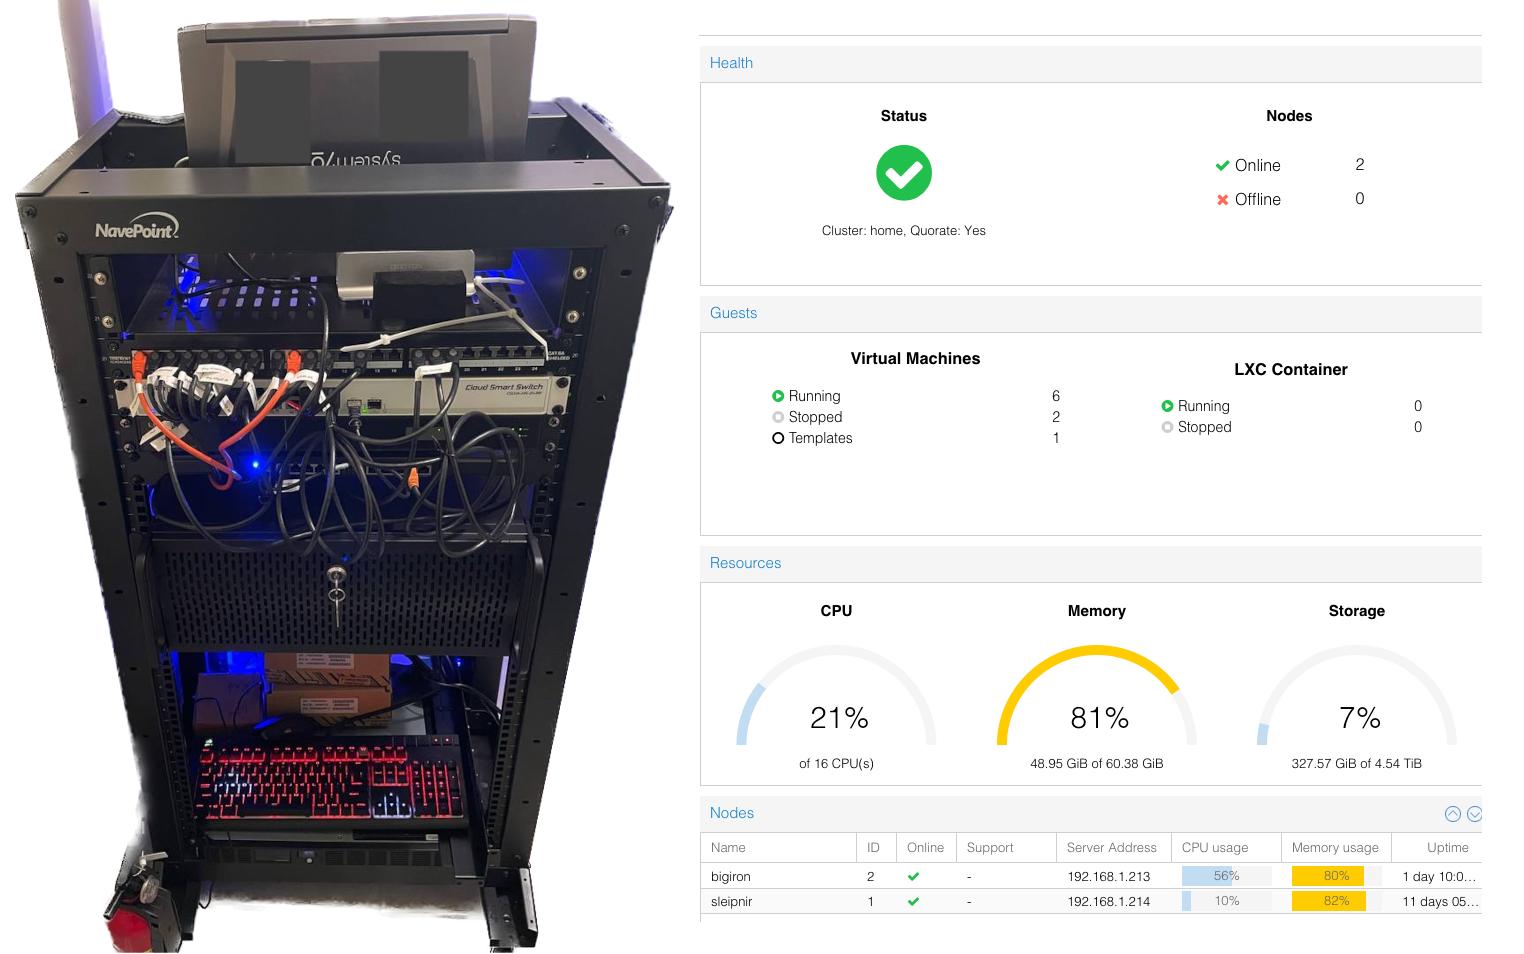
NAS의 CPU, 메모리, 디스크 사용량과 Docker 상태를 수집해 AI에 전달할 수 있다.
다음은 NAS의 현재 상태다.

CPU 사용률: 82%
메모리 사용률: 91%
디스크 사용률: 76%
Docker 컨테이너: 8개 실행 중

현재 상태를 분석하고 점검 순서를 제안해 줘.
이후 Docker API나 NAS 관리 API를 도구로 연결하면 단순한 상태 설명을 넘어 시스템 상태를 조회하는 AI 에이전트로 확장할 수 있다.
다만 컨테이너 중지나 파일 삭제처럼 시스템에 영향을 주는 작업은 반드시 사용자 승인 절차를 거치도록 구성해야 한다.
개인 문서 검색 시스템
Nemotron Embed와 Rerank를 함께 활용하면 NAS에 저장된 문서나 기술 자료를 검색하는 시스템을 만들 수 있다. (작은 모델을 활용하기 좋은 작업 중 하나다.)
-
회의록 핵심 내용 추출
-
문서의 항목별 분류
-
고객 문의 유형 구분
-
로그 파일의 오류 메시지 정리
-
JSON 형식으로 데이터 변환
예를 들어 다음과 같은 프롬프트를 사용할 수 있다.
다음 고객 문의를 분석해 JSON으로 반환하라.

문의:
"프로그램을 실행하면 10초 정도 후에 갑자기 종료됩니다."

분류 항목:
- 실행 오류
- 설치 오류
- 성능 문제
- 계정 문제
- 기타

출력 항목:
category
summary
severity
recommended_action
이처럼 정해진 형식으로 결과를 반환하도록 만들면 다른 프로그램과 연동하기도 편리하다.
8. 어떤 Nemotron을 선택해야 할까?
사용 목적에 따라 다음과 같이 선택하면 된다.
사용 목적추천 모델
| 작은 PC에서 로컬 챗봇 | Bolt E4B 4GB |
| 효율적인 일반 AI 에이전트 | Nemotron 3 Nano |
| 24GB GPU에서 로컬 에이전트 | Bolt 74B-A9B |
| 빠른 상시 실행형 에이전트 | Lightning |
| 이미지와 영상 분석 | Super VL |
| 복잡한 추론 및 대규모 작업 | Ultra |
| 실시간 음성 인식 | ASR Streaming |
| 긴 녹음의 전사와 분석 | Transcribe |
| 문서 검색 시스템 | Embed + Rerank |
| 콘텐츠 안전성 검사 | Content Safety |
9. 라이선스 확인
Nemotron은 모델마다 이용 조건이 다를 수 있다.
Bolt E4B의 모델 카드에는 OpenMDW License Agreement 1.1이 표시되어 있다. 다른 모델 역시 각 모델 카드의 라이선스와 사용 조건을 확인해야 한다.
상업적인 서비스에 적용하거나 모델을 재배포할 계획이라면 모델별 라이선스를 먼저 확인하는 것이 좋다.
마무리
NVIDIA Nemotron은 하나의 대형 언어 모델을 제공하는 프로젝트가 아니라, 다양한 환경과 작업에 맞춰 구성된 AI 모델 제품군이다.
Nano와 Bolt는 효율적인 로컬 AI 및 에이전트 작업에, Lightning은 빠른 상시 실행형 작업에, Super VL과 Ultra는 복잡한 추론과 멀티모달 작업에 초점을 맞춘다.
여기에 음성 인식, 문서 검색, 콘텐츠 안전성 검사 모델까지 조합하면 하나의 AI 시스템을 구성하는 데 필요한 다양한 요소를 확보할 수 있다.
개인용 PC에서 시작한다면 Bolt E4B 4GB부터 실행해 보는 것이 좋다. 이후 GPU 메모리와 시스템 환경에 맞춰 더 큰 모델이나 전문 모델을 추가하는 방식으로 확장할 수 있다.
공식 참고 링크
- NVIDIA Nemotron 전체 프로젝트: https://research.nvidia.com/labs/nemotron/projects/
- Nemotron 3 모델 제품군: https://research.nvidia.com/labs/nemotron/Nemotron-3/
- Nemotron 3.5 Super 및 Lightning: https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Super-and-Lightning/
- Nemotron 3.5 Bolt E4B: https://research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB/
- Nemotron 3.5 Bolt 74B: https://research.nvidia.com/labs/nemotron/Nemotron-3.5-Bolt-24GB/
- Nemotron 3 Ultra: https://research.nvidia.com/labs/nemotron/Nemotron-3-Ultra/
- Nemotron 3.5 Transcribe: https://research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Transcribe/
- NVIDIA Hugging Face: https://huggingface.co/nvidia
- llama.cpp: https://github.com/ggml-org/llama.cpp
'IT > AI Tools' 카테고리의 다른 글
| Vercel Agent Desktop - AI 에이전트가 Windows와 macOS 데스크톱을 직접 조작하는 방법 (0) | 2026.11.09 |
|---|---|
| be-ambitious - Claude에게 더 높은 수준의 작업을 요구하는 오픈소스 Skill (0) | 2026.11.07 |
| AI 이미지 생성에 유용한 카메라 구도 프롬프트 10가지 (0) | 2026.08.25 |


